


Un modelo que cualquiera puede descargar, modificar y usar sin pedir permiso. Para unos es la mejor garantía de que la IA no acabe en manos de cuatro empresas. Para otros, un riesgo que no se puede deshacer.
Te contamos qué hay detrás del debate y qué significa para tu trabajo.
Qué ha pasado
A finales de septiembre, Anthropic publicó un informe que señala a GLM-5.3, el modelo que la empresa china Z.ai lanzó en agosto, como un riesgo serio de ciberataques. El motivo: es abierto, cualquiera puede descargarlo y modificarlo.
El 13 de octubre, MIT Technology Review dedicó un análisis a la pregunta de fondo: ¿compensan las ventajas de los modelos abiertos sus riesgos?
Por qué te interesa
Primero, la diferencia. Un modelo cerrado (el de ChatGPT, Claude o Gemini) solo se usa a través de su web, su app o su API. Un modelo abierto se descarga: sus “pesos”, los números que definen cómo funciona, son públicos. Por eso también se llaman open-weight.
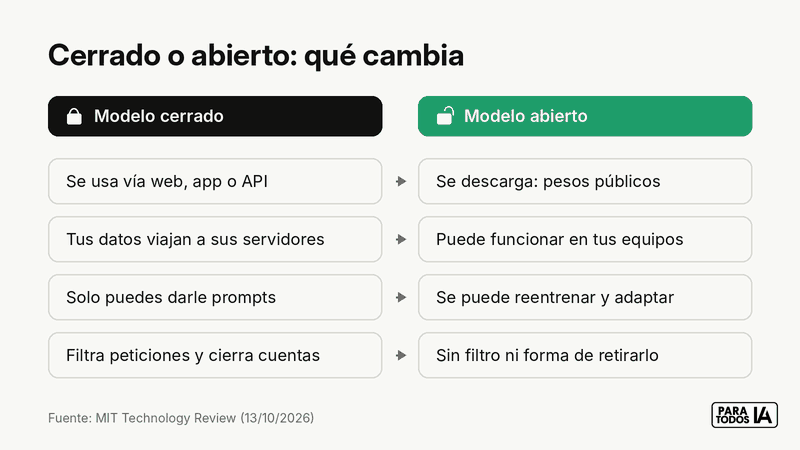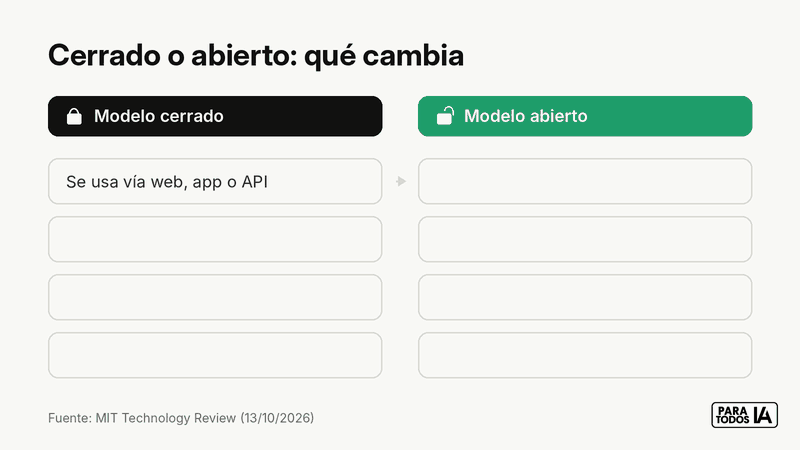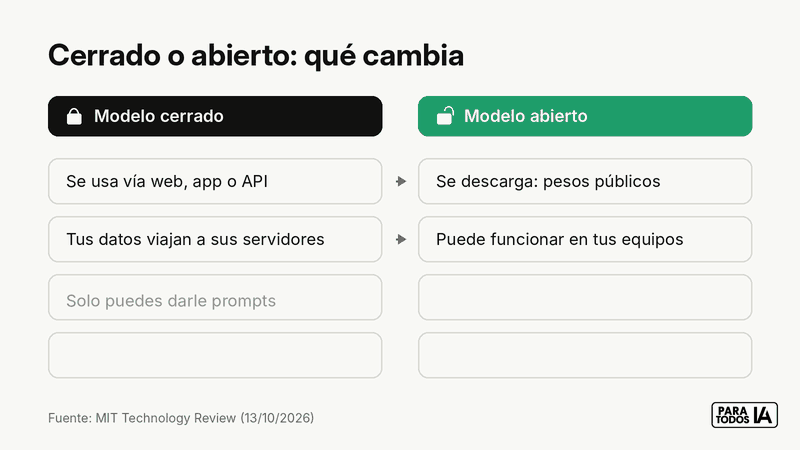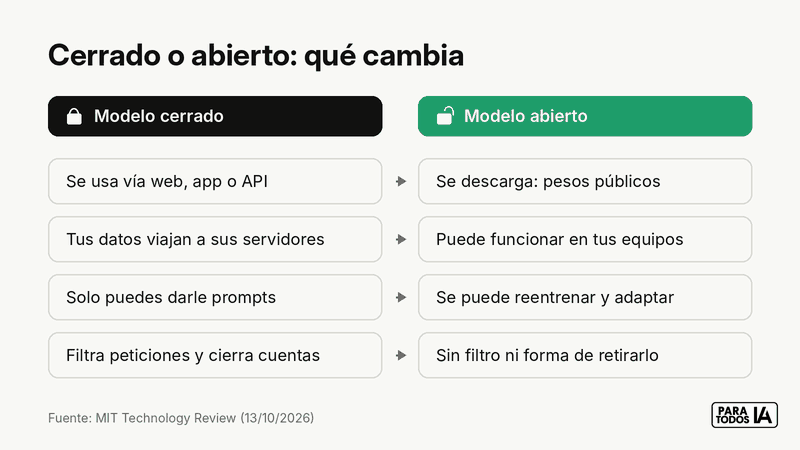
Esto tiene tres consecuencias prácticas:
1. Tus datos pueden no salir de casa. Un modelo abierto puede ejecutarse en tus propios equipos. Si trabajas con datos de clientes, alumnos o pacientes, es la forma más directa de que nada viaje a un servidor ajeno.
2. Suele costar menos. Según el informe State of Open Source AI de Mozilla, los modelos abiertos son normalmente más baratos que los cerrados, incluso si un proveedor externo los ejecuta por ti.
3. Se pueden adaptar. Con conocimientos y recursos, un modelo abierto se reentrena para tu sector, tu idioma o tu tarea. Con uno cerrado, solo puedes escribirle prompts.
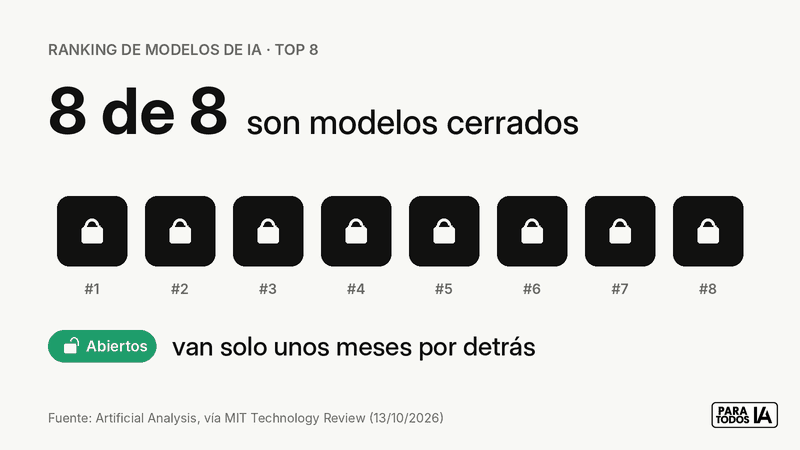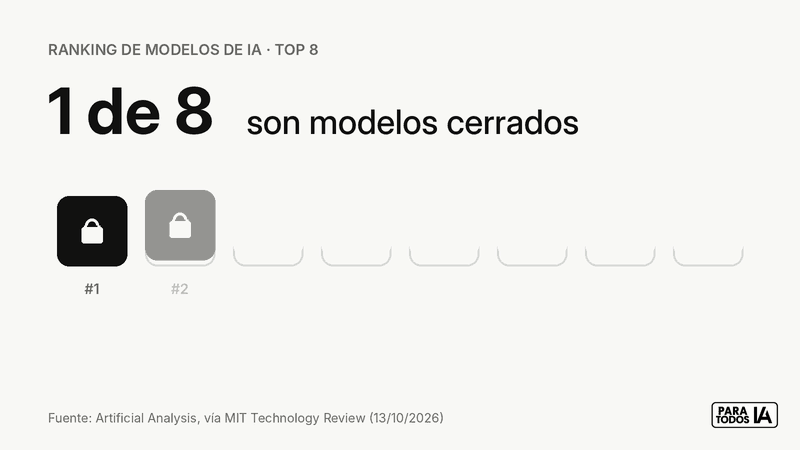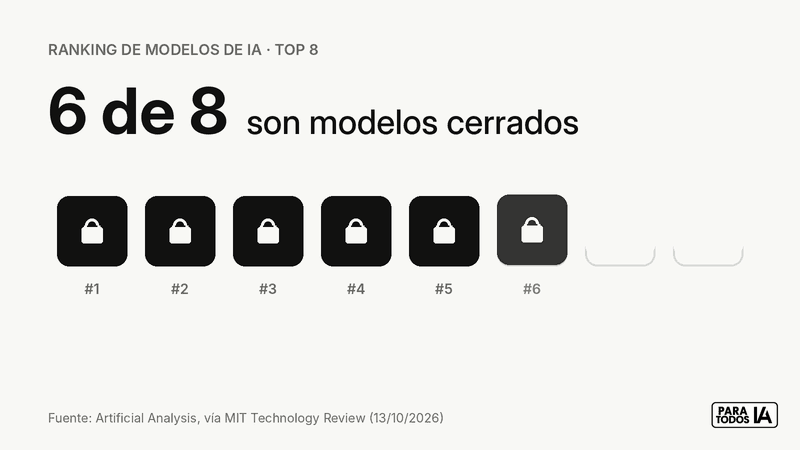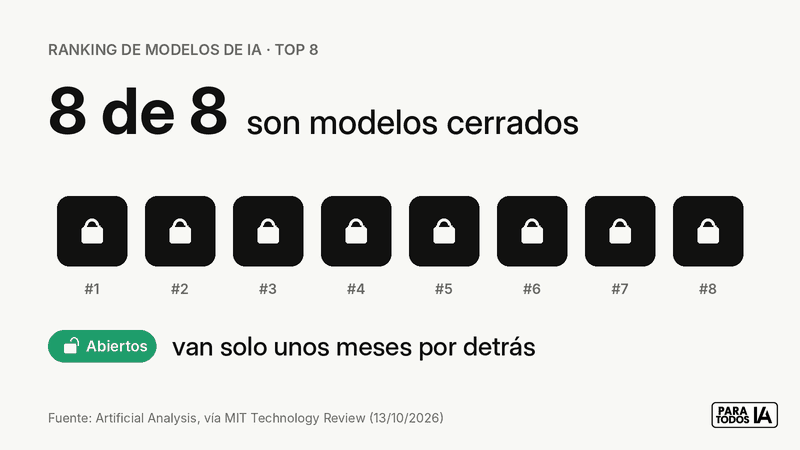
Y hay una cuarta, menos inmediata pero más importante. Como resume Elizabeth Seger, del Tony Blair Institute, en el artículo de MIT Technology Review: la cuestión de quién controla la infraestructura de la IA es tan grande como la de quién controló la información en internet. Para Europa y Latinoamérica, que no tienen ningún laboratorio en lo más alto del ranking, no es un debate menor.
La letra pequeña
Hay mucho dinero en juego. Jensen Huang, de Nvidia, defiende más modelos abiertos: cada empresa que los ejecuta en local compra chips. Dario Amodei, de Anthropic, pide prudencia: modelos abiertos, baratos y potentes compiten directamente con su negocio. Ninguno de los dos es neutral, y el informe sobre GLM-5.3 hay que leerlo también con esa lente.
Ni lo abierto es peligroso ni lo cerrado es seguro. El propio Anthropic reconoce en su informe de amenazas de septiembre varias operaciones de hacking hechas con ayuda de Claude. La diferencia real: con un modelo cerrado, la empresa filtra las peticiones peligrosas y puede cerrar cuentas. Con uno descargado, no hay filtro ni forma de retirar el acceso. Y los investigadores han demostrado que quitarle a un modelo abierto su entrenamiento de seguridad es sorprendentemente fácil.
“Abierto” no siempre significa abierto del todo. Publicar los pesos es el mínimo. Casi nunca se publican los datos de entrenamiento. Y sin chips caros, tener los pesos sirve de poco. Paul Azunre, de Ghana NLP, añade una crítica incómoda: algunas empresas publican modelos, observan cómo los mejora la comunidad y luego integran esas mejoras en sus productos sin reconocimiento ni compensación.
El debate ya no es todo o nada. Hay investigación en modelos resistentes a la manipulación, aunque según un preprint reciente ninguna técnica actual resiste todos los ataques. Y crece la idea de un lanzamiento por fases: el modelo nace cerrado y se abre a medida que se comprueba que es seguro.
Qué hacer en tu caso
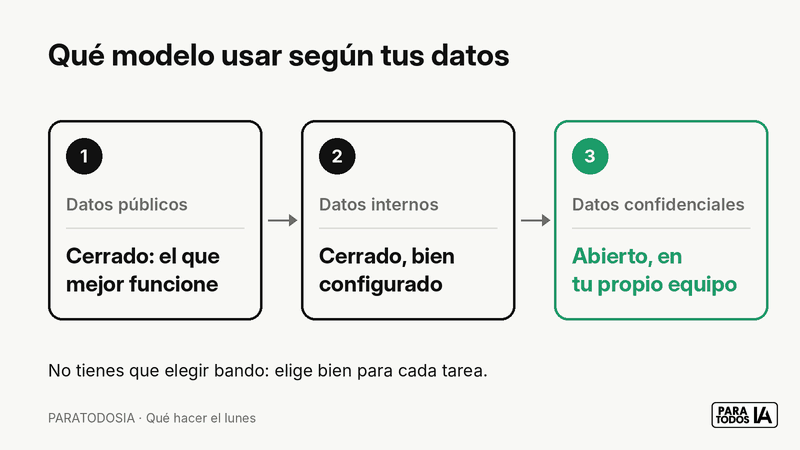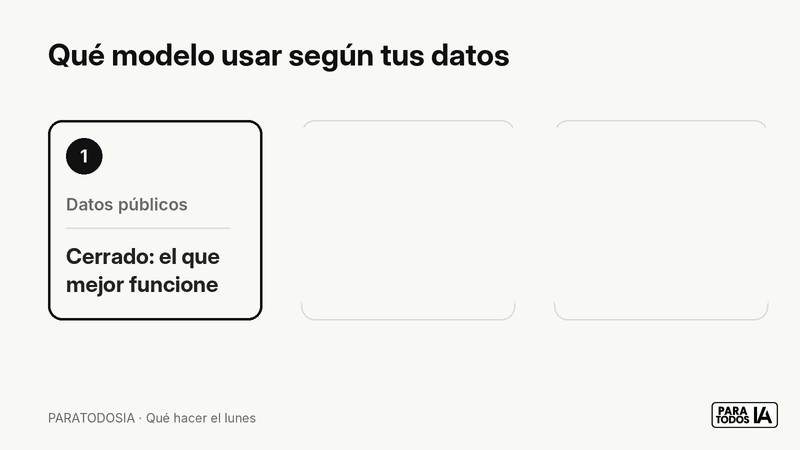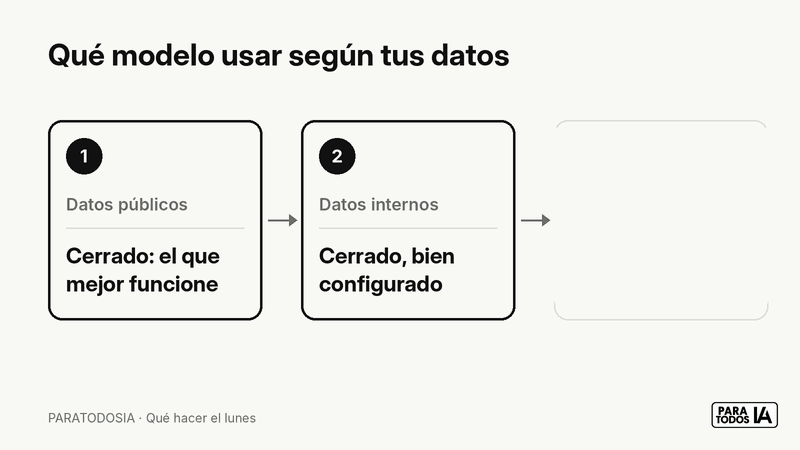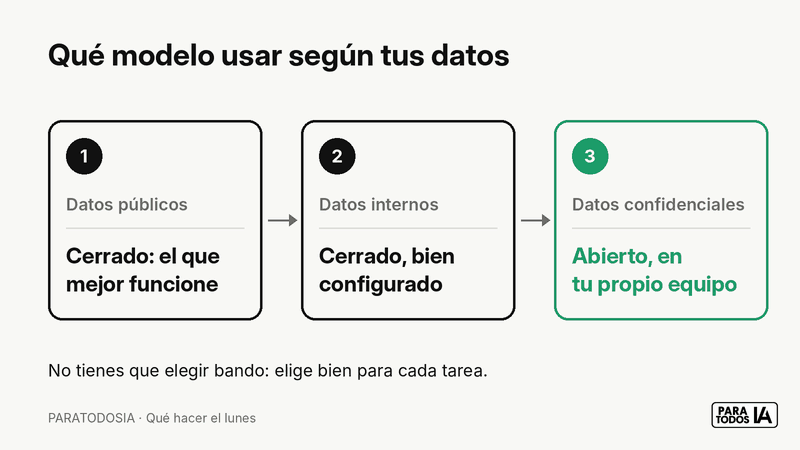
No tienes que elegir bando. Tienes que elegir bien para cada tarea.
Clasifica tus usos de IA en tres niveles: datos públicos, datos internos y datos confidenciales. Para los dos primeros, un modelo cerrado con buena configuración suele bastar.
Para lo confidencial, prueba un modelo abierto en local. Herramientas como LM Studio u Ollama permiten descargar y ejecutar modelos abiertos en un ordenador. Empieza con uno pequeño y una tarea sencilla: resumir un documento interno, por ejemplo.
Pregunta a tu proveedor dónde se procesan tus datos, si se usan para entrenar y qué pasa si cambian las condiciones. Si no lo sabes, no sabes cuánto dependes de él.
Y para decidir caso por caso, este prompt:
Actúa como consultor de adopción de IA en empresas. Voy a describirte una tarea que quiero hacer con IA. Para esa tarea, dime: 1) qué tipo de datos implica y su nivel de sensibilidad (público, interno o confidencial); 2) si me conviene más un modelo cerrado (ChatGPT, Claude, Gemini) o un modelo abierto ejecutado en local o en un proveedor propio, y por qué; 3) qué riesgos concretos tiene cada opción en mi caso; 4) qué necesito (hardware, conocimientos, presupuesto) para la opción abierta. Si te falta información, pregúntame antes de responder. Mi tarea es: [DESCRIBE LA TAREA, EL SECTOR Y QUÉ DATOS USARÍAS].
Nuestra lectura
Por Ángel González
En formación vemos a diario que el miedo a “subir datos a la IA” frena más proyectos que cualquier límite técnico. Los modelos abiertos no son la respuesta a todo, pero sí son la prueba de que existe una alternativa. Y una alternativa es lo que te da poder de negociación. La pregunta no es abierto o cerrado. Es qué tarea, con qué datos y bajo el control de quién. También hemos formado a equipos científicos que deben usar modelos abiertos si se adscriben a los planteamientos de Open Science de la UE. Tiene sentido por el nivel de apertura y porque permite una mejor reproducibilidad de los experimentos, que es una de las bases del método científico. También confesaré que las implicaciones de seguridad de estos modelos dan un poco de pavor.
Tu turno
¿Hay alguna tarea que hoy no haces con IA porque no te fías de dónde acaban tus datos? Cuéntanosla en comentarios y te decimos si un modelo abierto podría resolverla.
